DMD & DMDR
导言
多模态生成模型的推理速度一直受制于diffusion模型的多步去噪,这也限制了RL的迭代速度。为此DMDR解决了这个问题。可以结合DiffusionNFT+DMDR
导言
多模态生成模型的推理速度一直受制于diffusion模型的多步去噪,这也限制了RL的迭代速度。为此DMDR解决了这个问题。可以结合DiffusionNFT+DMDR
导言
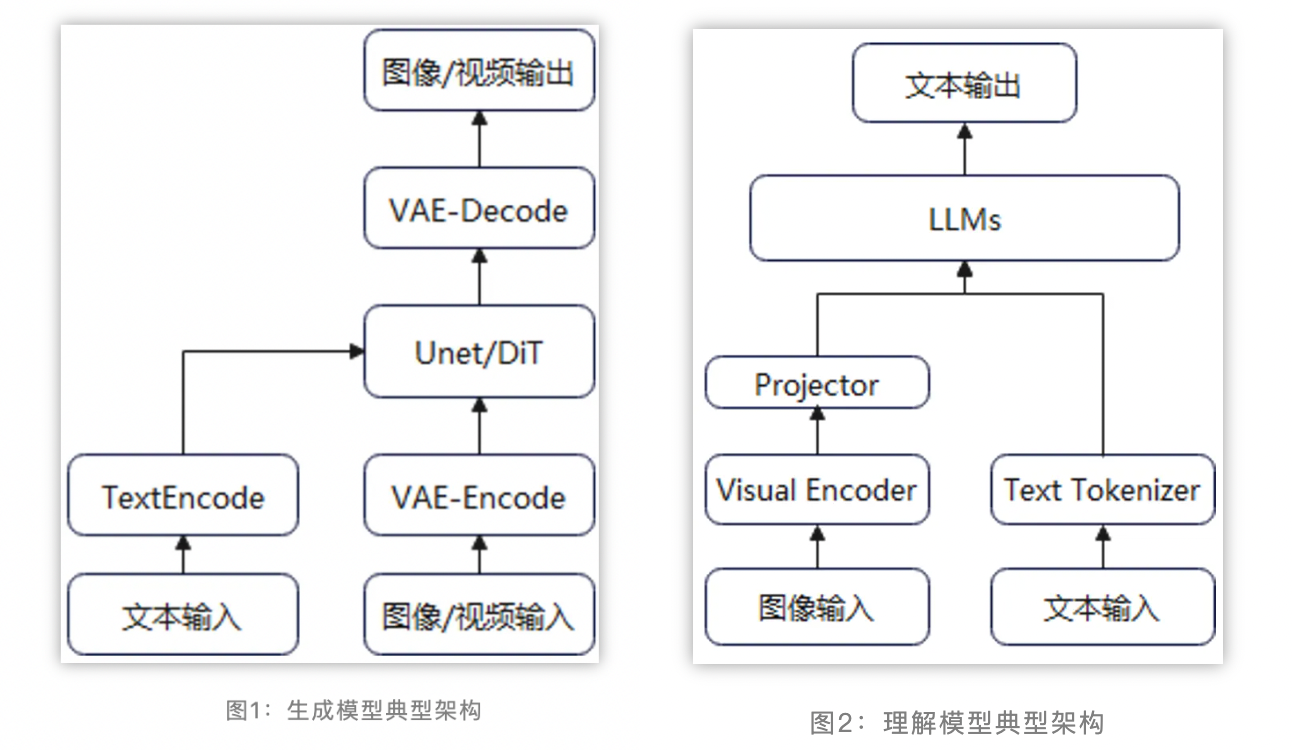
当前主流的多模态理解模型一般采用视觉编码器 + 模态对齐 + LLM的算法流程,充分复用已有视觉编码器的理解能力和LLM的基础能力。训练过程一般分为多个阶段,如先进行模态对齐的一阶段预训练,然后进行二阶段的参数微调。
排行榜:
导言
vllm 的ray后端属实奇诡,ray stop有残留,flush打印被吞(虽然输出能标记ip,折叠重复,在master输出),ray集群的环境变量固定不变导致DP无法实现多机。
为此考虑使用torchrun实现多机并行。
写得太好了,由浅入深。
导言
Speculative Decoding & eagle3 是种推理时计算换带宽的方法。
导言
HW24年狠抓了训练,但是推理性能稍微落下,dsv3的出现,强化学习的爆火,反过来对推理性能提出了很高的要求。为此高性能的vllm推理框架变成了hw首先适配的目标。
导言
来hw的这小半年成,从PTA到MM又来到DeepseekV3,接触了很多代码,但是却还是常陷入代码细节阅读困境,难以理解如天书般的垃圾代码。往往陷入代码细节,一读读几天,并且经常难以产出阶段性成果。
如何快速代码上手,
导言
作为卖NPU AI加速卡的软件员工, 目标是将昇腾的底层算力与上层多模态应用需求精准对接,释放昇腾AI算力,让客户看到NPU的性能、性价比、易用性、客户自身业务的使用需求。
导言
在LLM对齐的早期探索中,研究者们建立了两种影响深远的基础范式。
鉴于PPO-RLHF的复杂性,研究者们开始寻求更简洁、更直接的对齐方法。直接偏好优化(Direct Preference Optimization, DPO)应运而生,它巧妙地绕过了显式的奖励建模和复杂的RL优化循环,为偏好对齐提供了一个优雅的替代方案。
这篇文章介绍DPO, 和Step-Video论文介绍了Video-DPO, 这类训练中最后通过人工标注优化的方法。
必看好文6
导言
On-Policy Distillation(OPD)不是 top-k,也不等于 RL。它先让学生模型生成自己的轨迹,再让教师在学生实际到达的前缀上提供 token 分布,以减少训练与部署时的状态分布偏移。
OPD 能否生效,关键不是教师参数量是否更大,而是师生是否共享可比较的动作空间、思维模式是否兼容,以及教师是否真的提供了学生尚未掌握的知识。本文同时梳理 DeepSeek V4、Qwen3/Qwen3.5、Qwen3.5-Omni 的公开流程,以及 verl/verl-omni 的现有能力与缺口。
导言
Step-Video论文详细介绍了AI 系统的一些构建细节。