Mooncake Store Design
导言
Mooncake Store 的 KV Cache 管理很像 PagedAttention:两者都采用 切块、间接寻址、按块复用与淘汰。但它们解决的不是同一层问题。PagedAttention 管理单个推理实例内的 GPU KV Block;Mooncake Store 管理跨请求、跨实例、跨节点的 DRAM 与 SSD 副本。
理解二者关系的关键,是先区分 页表 与 KV 数据页:页表记录当前请求的逻辑块对应哪个 GPU 物理块,真正跨显存、内存和 SSD 分层迁移的是 K/V 张量数据,而不是页表本身。
但只理解“Master 管元数据、Client 传数据”仍然不够。本文沿 Mooncake 固定版本 bfca1ce2af8419c50dc8d464820a95d97d43c930 追到 store_c.cpp、real_client.cpp、client_service.cpp、master_service.cpp 与 transfer_task.cpp,解释每个设计判断究竟由哪段代码实现。
一句话结论:Mooncake Store 是一个面向不可变对象的双平面分布式缓存:Master 分配空间并原子发布副本元数据,Client 贡献注册内存或 SSD 容量并通过 Transfer Engine 直传字节;用于 KV Cache 时,外部命中仍需装入 GPU Block,再更新 PagedAttention Block Table。
先区分页表与数据页
讨论 KV Cache 的“页”时,最容易把三个不同对象混在一起:
- 逻辑 KV Block:请求按 Token 顺序切分出的第 0、1、2 个块。
- GPU 物理 Block:K/V Tensor 在本次运行中实际占用的显存块。
- Block Table:保存“逻辑块序号 → GPU 物理 Block ID”的映射。
设请求的逻辑块序列为 \(L_0,L_1,L_2,\ldots\),PagedAttention 为它们分配 GPU 物理块 \(P_0,P_1,P_2,\ldots\),页表保存的是:
严格来说,页表不是 KV Cache 数据本身。vLLM Scheduler 在 CPU 侧保存请求、引用计数、Block Hash 与所有权等调度元数据;Attention Kernel 使用的 Block Table 则位于设备侧,内容是 GPU Block ID。SSD 不保存这张临时页表,页表也不会直接指向 SSD 文件。
同一段前缀下一次被其他请求命中时,内容身份仍可由相同的 Block Hash 表示,但本次分配到的 GPU Block ID 可能完全不同。新的页表只需重新建立逻辑块到新物理块的映射。
不是透明缺页
这套机制与操作系统虚拟内存有相似直觉,但 Mooncake 与 vLLM 没有让 Attention Kernel 透明访问 SSD 的硬件缺页机制。外部缓存命中后,调度器和 Connector 必须显式完成查询、GPU Block 分配、数据传输和同步,之后才能执行 Attention。
两级管理全景
下图把两套映射放在一起:上层是 PagedAttention 的 GPU 执行地址,下层是 Mooncake Store 的内容身份与副本位置。绿色路径表示真正的 KV 数据传输,蓝色与紫色路径表示地址和元数据查询。
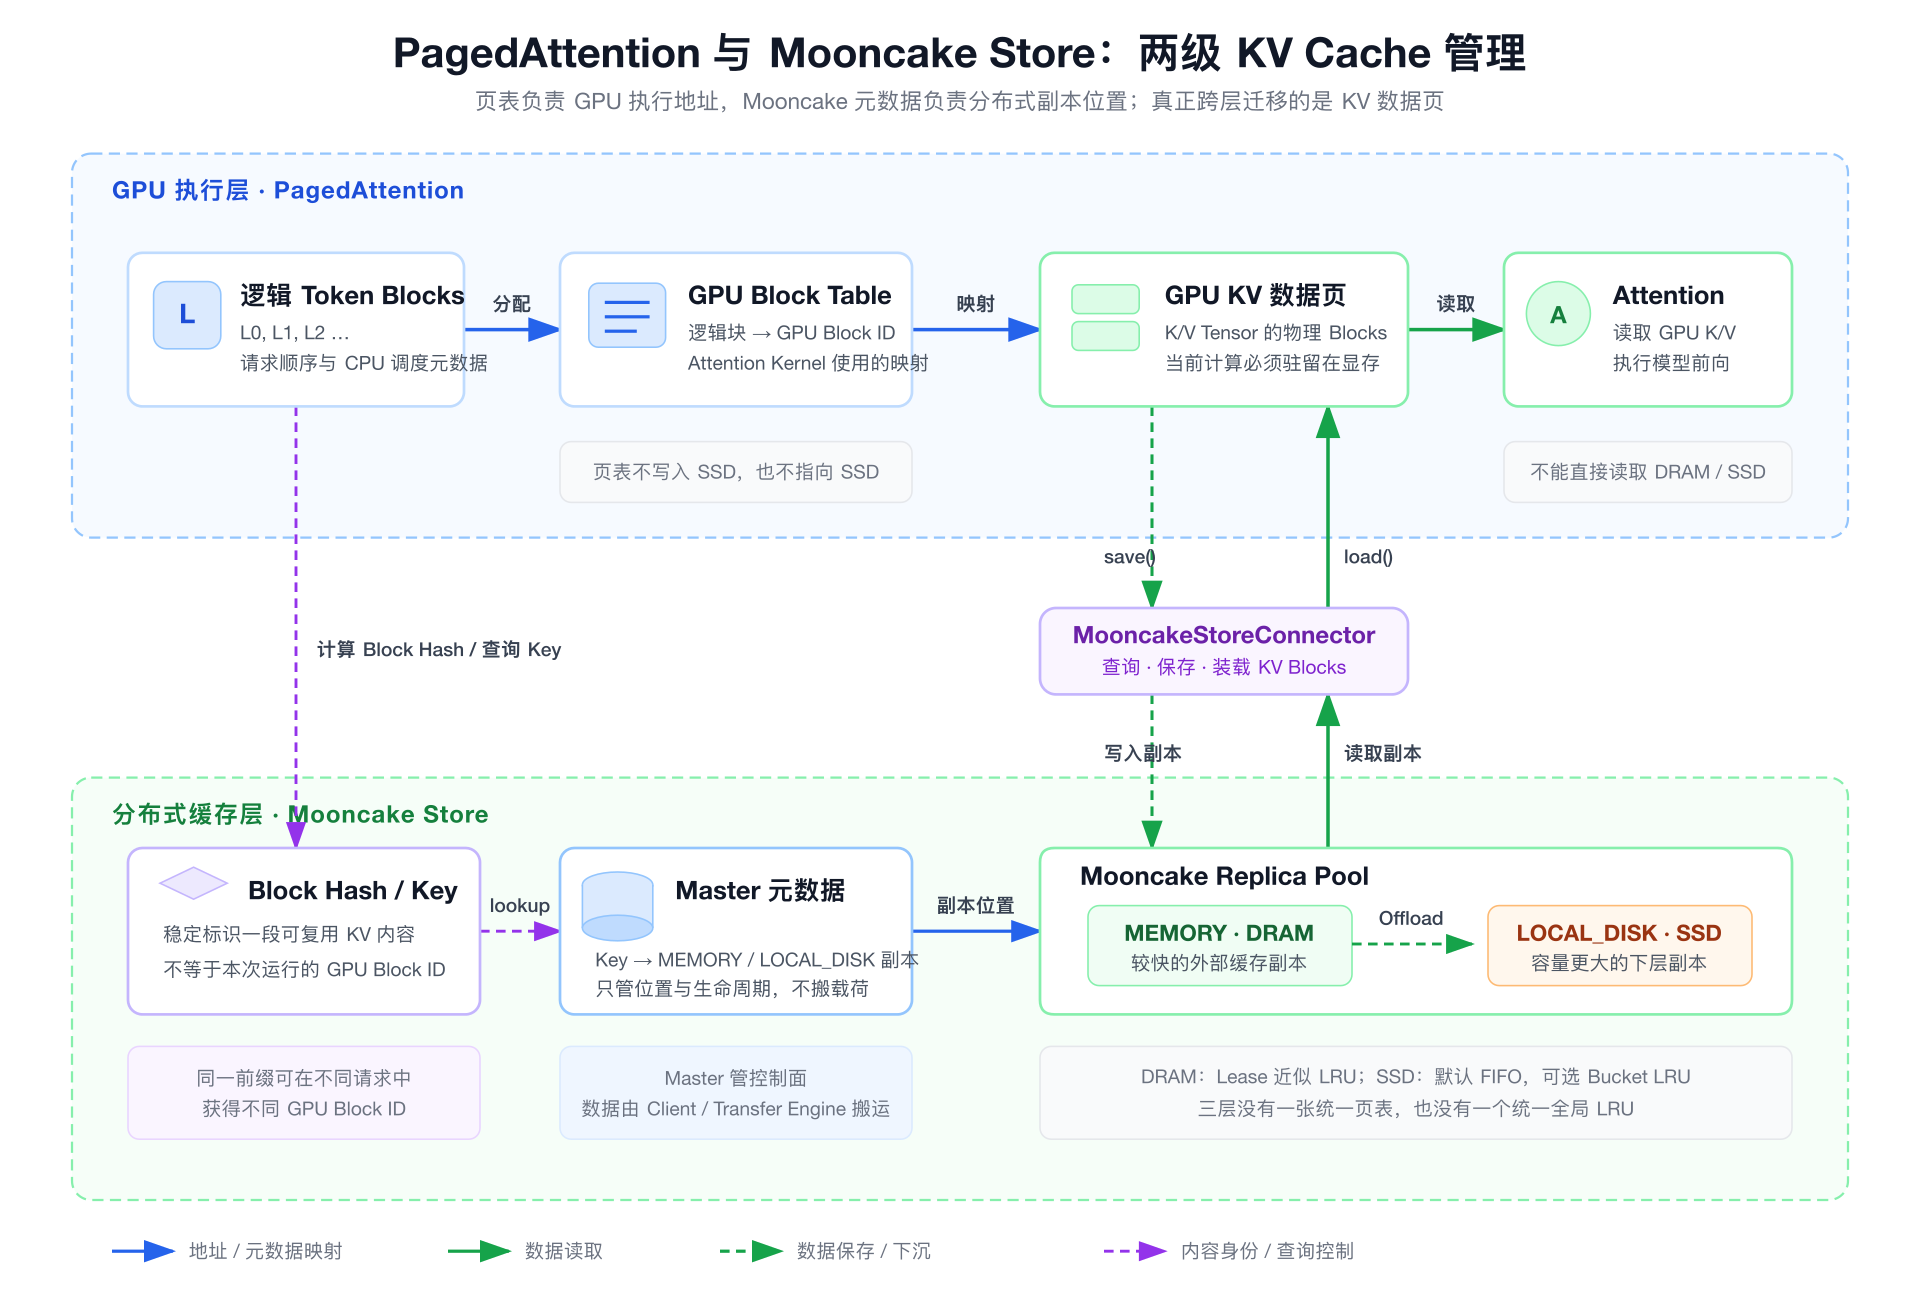
图中最重要的是两组映射彼此独立:
二者通过 MooncakeStoreConnector 衔接。Connector 把 GPU 中已经计算好的 KV Block 保存到外部 Store,也把外部命中的 KV Block 装载到 vLLM 新分配的 GPU Block。
| 对比项 | PagedAttention | Mooncake Store |
|---|---|---|
| 管理范围 | 单个推理实例的 GPU 显存 | 跨请求、实例、节点的 DRAM/SSD 缓存池 |
| 逻辑标识 | 请求的第几个逻辑 Token Block | Block Hash / Mooncake Key |
| 物理位置 | GPU KV Tensor 的 Block ID | MEMORY、LOCAL_DISK 等副本位置 |
| 映射结构 | GPU Block Table | Master 中的对象与副本元数据 |
| 直接服务对象 | Attention Kernel | KV Connector 与 Transfer Engine |
| 主要目标 | 减少显存碎片并复用 GPU Block | 扩大可复用 KV Cache 的容量与范围 |
代码里的系统边界
官方设计文档把 Mooncake Store 定义为面向大语言模型 KV Cache 的分布式键值存储,Key 由内容派生,Value 写入后不可变。这个定义在代码里展开成两条彼此分离的路径:控制面决定对象放置、状态与生命周期,数据面负责对象字节的实际移动。
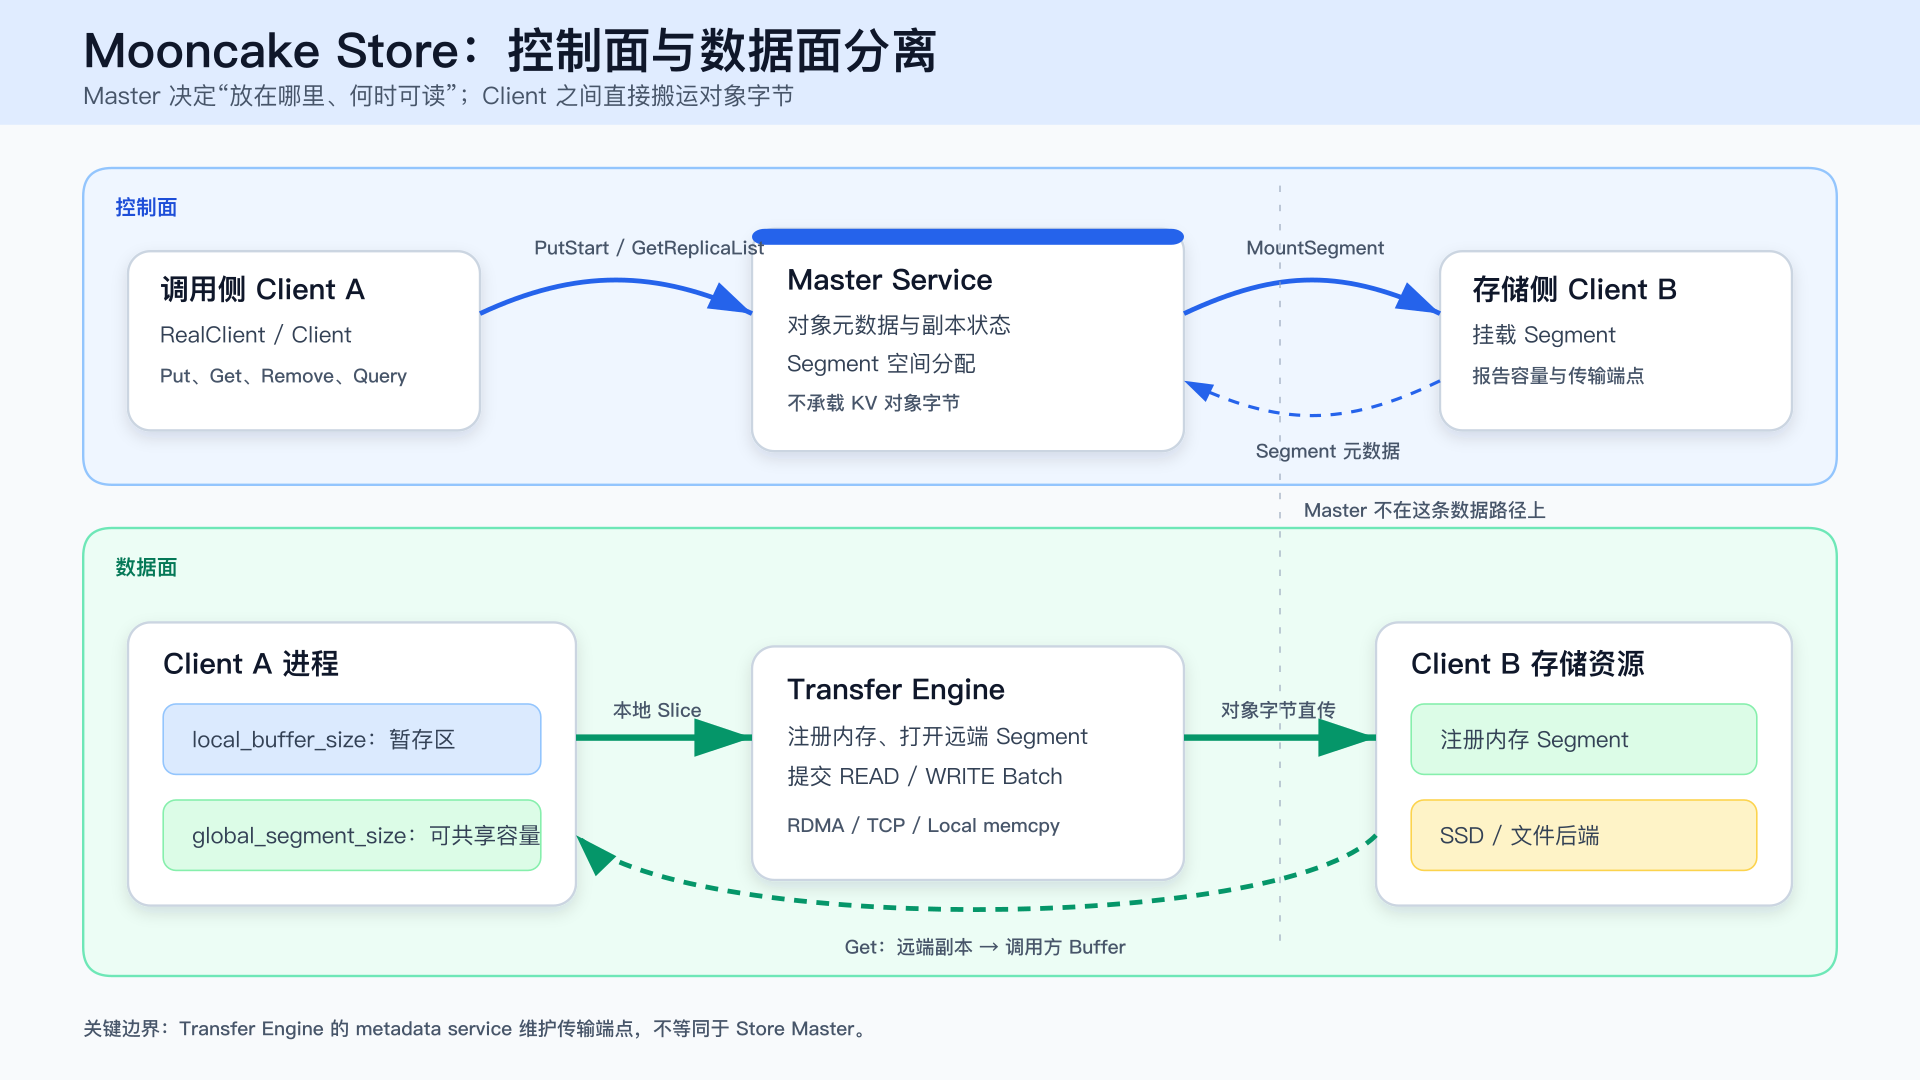
控制面与数据面
- Store Master 是控制面。
MasterService保存对象元数据、选择 Segment、分配副本位置、管理 Lease,并把副本从PROCESSING发布为COMPLETE。正常 Put/Get 的对象字节不进入 Master。 - Store Client 同时是调用方和存储节点。 同一个
Client可以向 Master 发起 Put/Get,也可以调用MountSegment把本进程内存注册为其他 Client 可访问的存储空间。 - Transfer Engine 是数据面。 Client 根据 Master 返回的 endpoint、远端基址和 offset,提交 RDMA、TCP 或本地 memcpy 请求,直接在源 Slice 与目标 Segment 之间搬运字节。
- Transfer Engine metadata service 不是 Store Master。 前者维护传输端点和连接所需的元信息,后者维护对象、空间、副本与租约。两者可以同时出现在部署参数中,但职责不能合并理解。
Master 不转发数据
PutStart 返回的是“可以写到哪里”,GetReplicaList 返回的是“可以从哪里读”。之后的 TransferWrite 与 TransferRead 都由 Client 侧执行。把 Master 画在数据箭头上,会误判它的带宽瓶颈、故障影响和扩容方式。
两种内存不是一回事
RealClient::setup_internal 接收两个容易混淆的容量参数:
| 参数 | 代码动作 | 是否贡献 Store 容量 | 主要用途 |
|---|---|---|---|
local_buffer_size |
创建 ClientBufferAllocator,并把本地缓冲区注册到 Transfer Engine |
否 | put 的 gather/staging、get 的本地目标缓冲区 |
global_segment_size |
分块分配内存,逐块调用 Client::MountSegment |
是 | 作为远端 Client 可分配、可读写的 MEMORY Segment |
由此可以组合出三种角色:
- 双角色节点:两个值都大于 0,既能调用 Put/Get,也向全局池贡献内存。
- 纯调用节点:
global_segment_size = 0,只消费其他节点挂载的容量。 - 纯存储节点:
local_buffer_size = 0,按设计文档语义只提供 Segment,不执行依赖本地缓冲池的 Put/Get。
Store 还提供三种接入形态:直接链接 Client 的 embedded 模式;应用连接本机共享内存代理的 dummy-real 模式;以及独立 Store 服务进程。三者改变进程边界,却不改变 Master 控制面与 Client 数据面的分工。
核心类如何分工
从 C API 入口向下看,Mooncake Store 不是一个承担所有职责的“大 Store 类”,而是 API 适配、Client 编排、传输执行和 Master 元数据四组对象的组合。
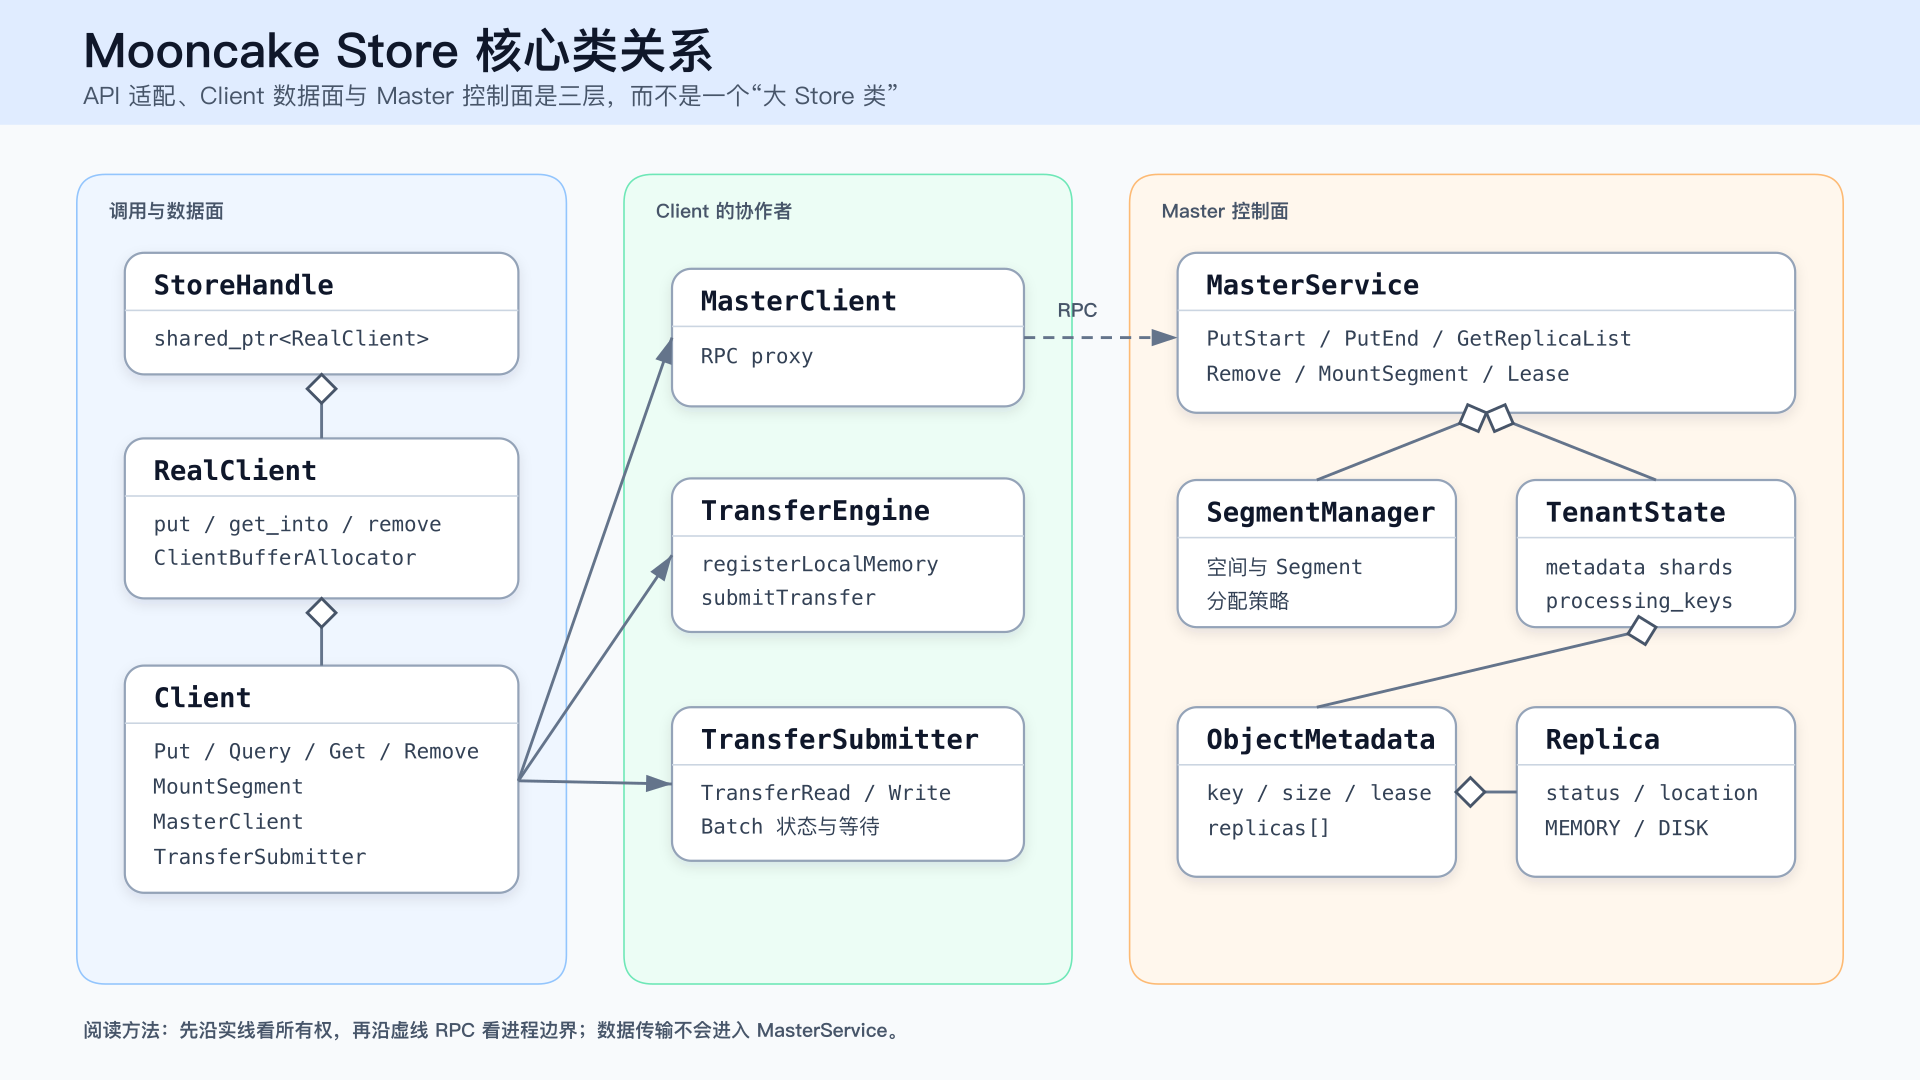
| 类或结构 | 所在代码 | 责任 |
|---|---|---|
StoreHandle |
mooncake-store/src/store_c.cpp |
C ABI 句柄,持有 shared_ptr<RealClient> |
RealClient |
include/real_client.h、src/real_client.cpp |
把连续 Buffer 转为 Slice,管理本地缓冲池,兼容 real/dummy-real 两种接入 |
Client |
include/client_service.h、src/client_service.cpp |
编排对象 API、Master RPC、Transfer Engine、Segment 与存储后端 |
MasterClient |
include/master_client.h、src/master_client.cpp |
MasterService 的 RPC 代理,封装 BRPC 调用;Client::ConnectToMaster 负责地址连接与 HA leader 发现 |
TransferSubmitter |
include/transfer_task.h、src/transfer_task.cpp |
把 Replica 读写转换为 local memcpy、Transfer Engine、SPDK 或文件任务 |
MasterService |
include/master_service.h、src/master_service.cpp |
管理 Segment、分配策略、对象元数据、副本状态、Lease、配额与淘汰 |
ObjectMetadata |
include/master_service.h |
对象账本:不可变尺寸和类型、writer、Lease、Pin、Replica 列表 |
Replica |
include/replica.h |
一个物理副本的位置、类型、引用计数与生命周期状态 |
MasterService 按租户维护 TenantState,对象元数据被分散在多个 shard 中;processing_keys 记录尚未完成发布的 Key。每个 ObjectMetadata 再持有多个 Replica。Replica 不只是一个地址,它还包含 MEMORY、NoF、LOCAL_DISK、DFS 等位置描述,以及 PROCESSING、COMPLETE、FAILED、REMOVED 等状态。
源码导航:C API 与 StoreHandle、RealClient、Client、MasterService 与 ObjectMetadata、Replica。
一致性的真正载体
Mooncake 的强一致读不是由“Master 代理所有副本写入”实现的,而是由 不可变 Value、写入期间不可读、成功后原子发布 共同实现。GetReplicaList 只返回满足可读条件的 COMPLETE 副本。
初始化如何建立资源池
生命周期先由 mooncake_store_create 创建 C ABI 句柄,再由 mooncake_store_setup 初始化内部 Client:
mooncake_store_create
  → RealClient::create
  → StoreHandle{shared_ptr<RealClient>}
mooncake_store_setup
  → RealClient::setup_real
  → RealClient::setup_internal
  → Client::Create
      → ConnectToMaster
      → 初始化 Transfer Engine
      → InitTransferSubmitter
  → 注册 local buffer(若 local_buffer_size > 0)
  → MountSegment(若 global_segment_size > 0)
这里有两个先后依赖:Client 必须先连接 Master,才能取得 Store 配置并挂载 Segment;本地内存必须先向 Transfer Engine 注册,远端 Client 才能用 endpoint 与地址执行零拷贝传输。 Client::MountSegmentAndGetId 会先注册可远端访问的内存,再构造 Segment,最后通过 MasterClient::MountSegment 把容量加入 Master 的逻辑池。
对应实现:RealClient::setup_internal、Client::Create、Client::MountSegmentAndGetId。
“零拷贝”需要加边界条件:当调用方直接使用已注册内存并走 RDMA 路径时,可以避免中间复制;便利接口 RealClient::put 仍可能先把输入 gather 到 ClientBufferAllocator。因此更准确的说法是 数据路径支持零拷贝,而不是每个 API 调用天然零拷贝。
Put 为什么分成两阶段
Put 的核心不是一次 RPC,而是 控制面预留 → 数据面写入 → 控制面发布。这类似数据库的 prepare/commit,但提交对象是不可变副本元数据。
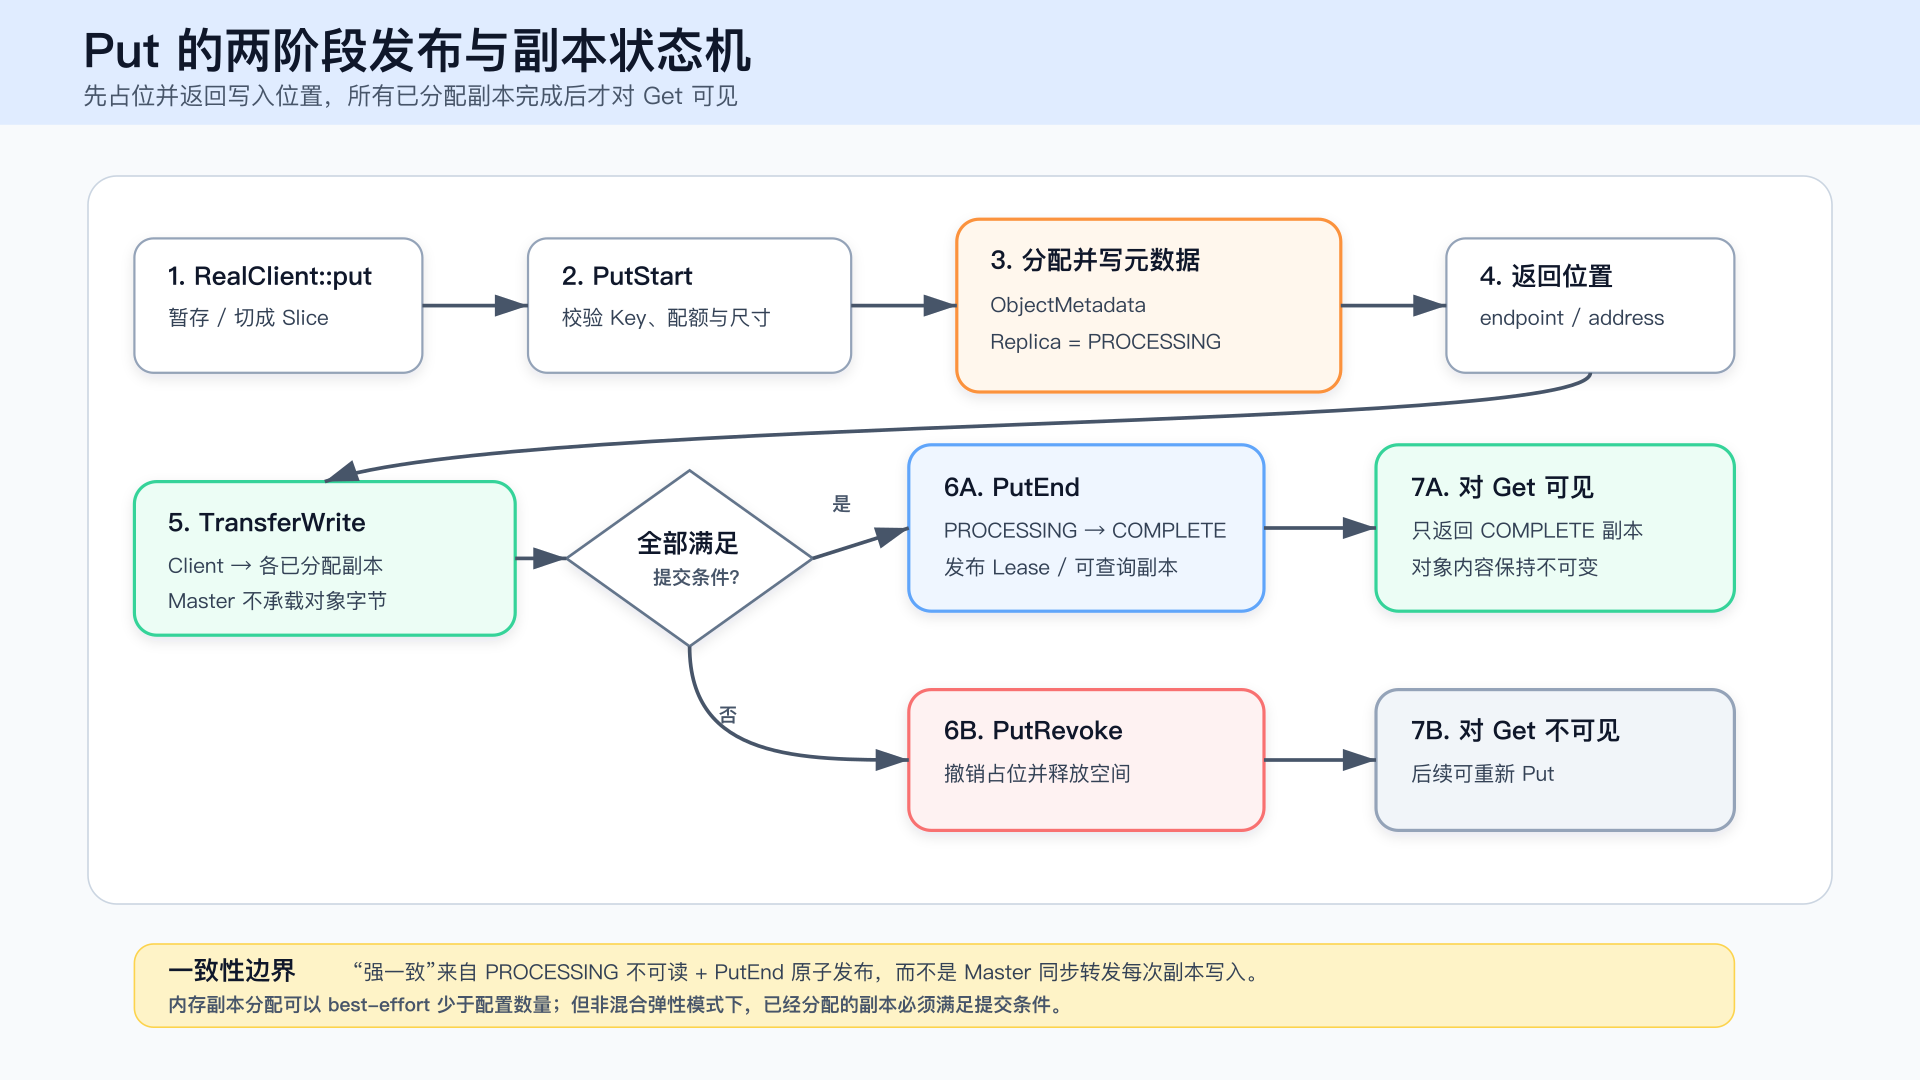
第一阶段:预留位置
Client::Put 先计算 Slice 长度和可选 checksum,再调用 MasterClient::PutStart。Master 侧完成四件事:
- 校验不可变约束。 同一 Key 已存在且尺寸或属性不兼容时,拒绝覆盖。
- 检查配额与分配策略。 Allocation Strategy 从不同 Segment 中选择副本位置,避免把多个内存副本放到同一个 Segment。
- 写入占位元数据。 创建
ObjectMetadata,把 Replica 标记为PROCESSING,并把 Key 加入processing_keys。 - 返回物理描述。 MEMORY 副本包含 Transfer Engine endpoint、远端地址与长度;磁盘副本包含对应的存储描述。
内存副本的“多副本”是 分配层面的 best-effort:若配置要求多个副本但容量不足,只要至少成功分配一个,Put 仍可能继续。这个语义不等于传输阶段可以随意丢副本;在普通模式下,已经分配的副本都必须成功写完,混合 MEMORY + NoF 的弹性模式才有不同的提交判定。
第二阶段:直传并发布
Client 遍历已分配副本。MEMORY/NoF 路径进入 TransferWrite,LOCAL_DISK/DFS 路径进入对应存储后端。TransferSubmitter::submit 再根据位置类型路由:
MEMORY 且本地  → LOCAL_MEMCPY
MEMORY 且远端  → TRANSFER_ENGINE
NoF            → SPDK / NoF 任务
LOCAL_DISK/DFS → 文件或分布式存储任务
远端 MEMORY 路径会分配 BatchID、按 endpoint 打开远端 Segment、构造本地源地址与远端基址加 offset 的 TransferRequest,提交后等待完成。全部结果交给 DetermineFinalizeDecision:
- 满足提交条件:调用
PutEnd。Master 只允许原 writer 提交,把对应 Replica 从PROCESSING改为COMPLETE,移除 processing 标记,授予 Lease,并按配置触发 SSD Offload。 - 不满足提交条件:调用
PutRevoke,撤销未发布对象并释放预留空间。
因此,读取者不会看到“只有一半字节写好”或“只有部分已分配副本写好”的对象。可见性发生在 PutEnd,不是第一次 DMA 完成时。
对应实现:Client::Put、MasterService::PutStart、MasterService::PutEnd、TransferSubmitter::submit。
Get 为什么绕开 Master
Get 被拆成 Query 和 TransferRead 两步。第一步拿可读副本清单与 Lease,第二步才搬运对象字节。
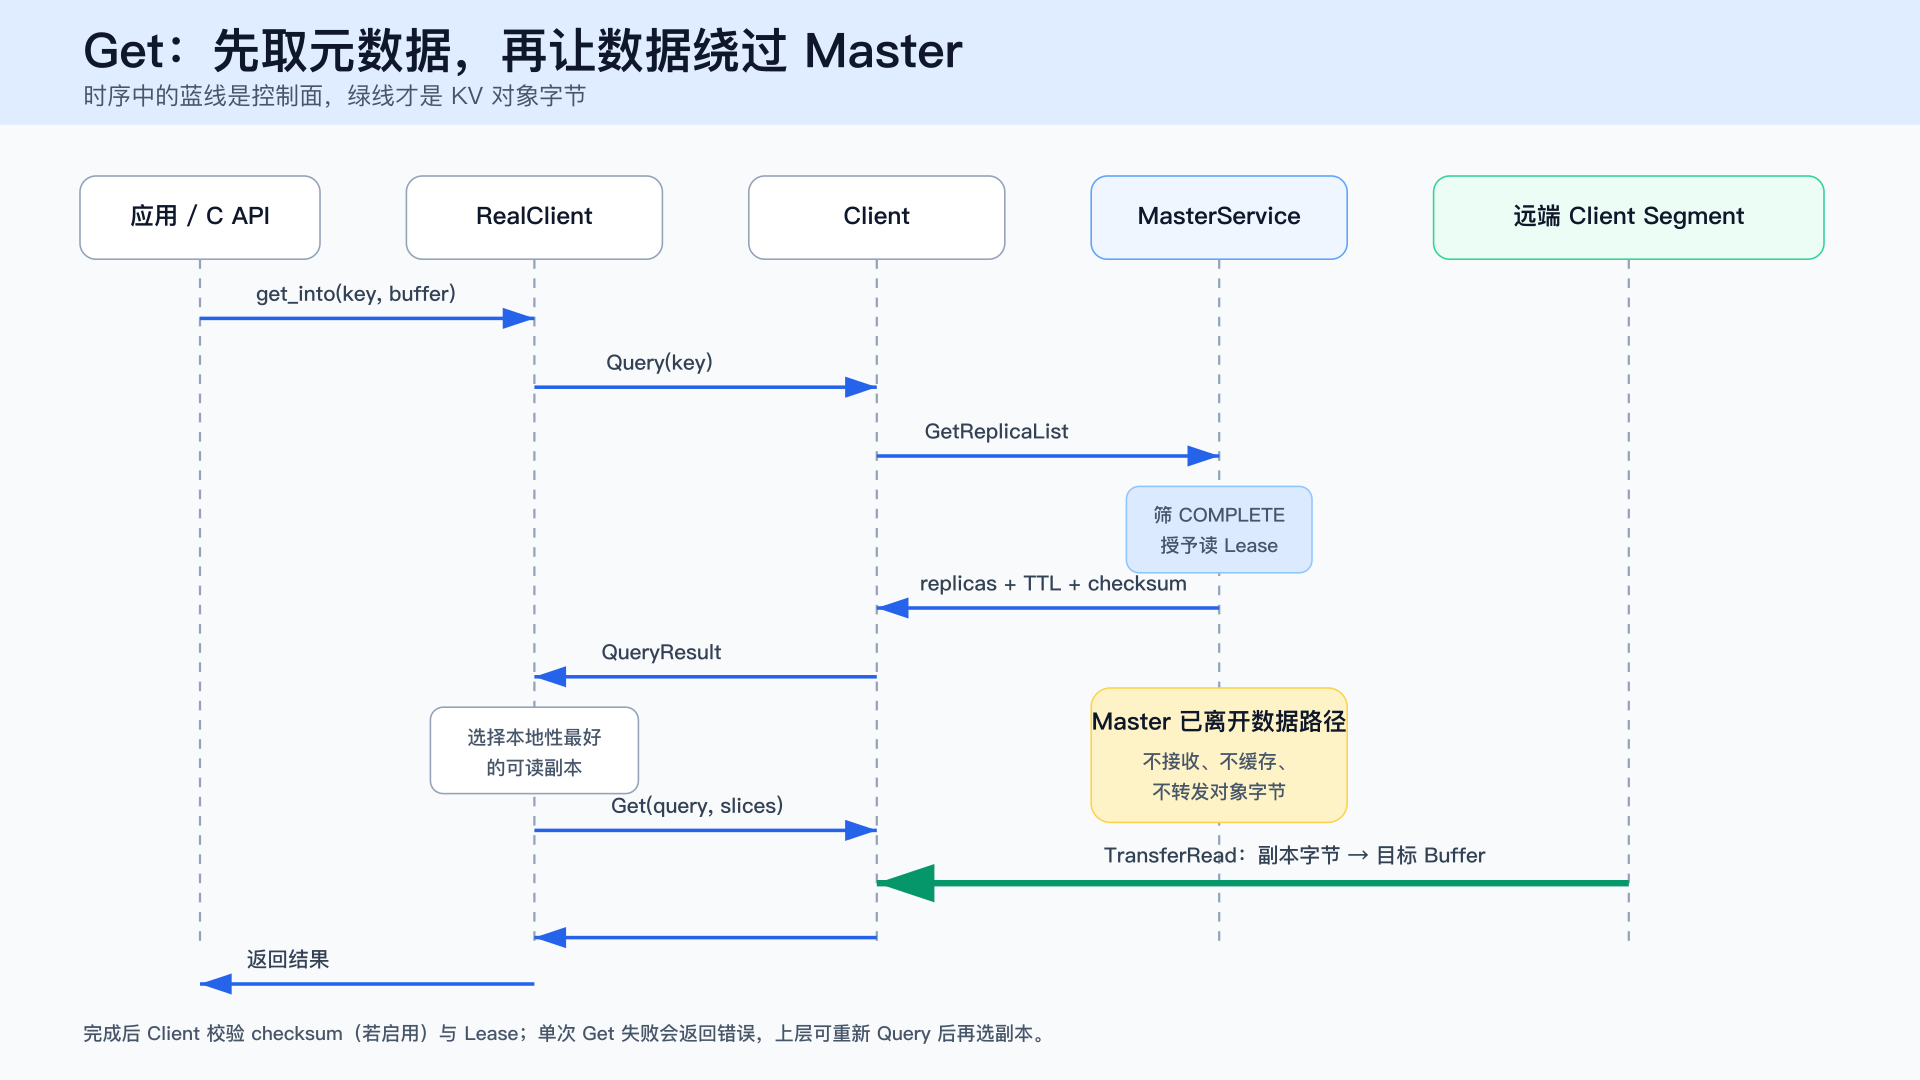
RealClient::get_into 先为目标 Buffer 建立 ranged-read metadata,再调用 Client::Query。MasterService::GetReplicaList 过滤掉不可读副本,只返回有效的 COMPLETE Replica,同时更新对象或 Group 的读 Lease,并返回 TTL、checksum 等信息。
Client 随后按实现中的固定优先级选择副本:本地 MEMORY、任意 MEMORY、本地 NoF、任意 NoF、LOCAL_DISK、DFS、DISK。Client::Get 再执行 hot-cache、MEMORY/NoF、DFS 等具体读路径;远端内存使用与 Put 对称的 TransferRead。传输结束后还会执行两个检查:
- 数据完整性。 启用 checksum 时,目标内容必须与元数据一致。
- 租约有效性。 如果传输期间 Lease 已过期,这次结果不能被无条件视为有效。当前单次
Client::Get会返回失败;上层可以重新 Query,再选择其他COMPLETE副本重试。
这也解释了 Master 的扩展边界:对象带宽随 Client 和网络扩展,Master 主要承受元数据 QPS、空间分配与 Lease 管理压力。 默认单 Master 仍是控制面单点;高可用模式通过 etcd 选主和 Master 发现恢复控制面,但不会把 Master 变成数据代理。
对应实现:Client::Query、Client::Get、MasterService::GetReplicaList、TransferSubmitter::submitTransfer。
特性如何落到代码
| 设计特性 | 实现机制 | 关键代码 | 使用边界 |
|---|---|---|---|
| 对象语义 | 内容派生 Key、不可变 Value、Put/Get/Remove/Query | Client、ObjectMetadata |
覆盖写应换 Key 或先 Remove |
| 多副本 | Allocation Strategy 选择不同 Segment,Replica 列表记录位置 | AllocateAndInsertMetadata、Replica |
分配数量 best-effort,实际持久性取决于成功副本与介质 |
| 强一致读 | PROCESSING 不可读,PutEnd 原子发布 COMPLETE |
PutStart、PutEnd、GetReplicaList |
强调单对象发布,不代表跨 Key 事务 |
| 高带宽 | Slice 并行、Transfer Batch、Client-to-Client 数据路径 | TransferSubmitter、TransferEngine |
仍受注册内存、链路和目标介质限制 |
| 零拷贝能力 | 注册内存与 RDMA 直接访问 | RegisterLocalMemory、submitTransfer |
RealClient::put 的便利路径可能有 staging copy |
| 动态扩缩容 | Client 挂载或卸载 Segment,Master 更新逻辑池 | MountSegment、UnmountSegment |
缩容需处理活跃 Replica 与 Lease |
| 故障容忍 | 多个 COMPLETE Replica、失败副本过滤、HA Master |
IsReplicaReadable、etcd leader coordinator |
至少要有可读副本;默认单 Master 并非 HA |
| DRAM/SSD 分层 | MEMORY Replica、LOCAL_DISK Replica、Offload 与独立淘汰 | FileStorage、后台 eviction/offload |
SSD 副本可能立即生成,不必然只存冷数据 |
不要把宣传词当成无条件保证
“任意节点失败仍可用”“零拷贝”“配置 N 副本就一定得到 N 副本”都需要部署前提。源码真正保证的是:只发布满足提交条件的对象,只向读者返回有效完整副本,并为注册内存提供绕过 Master 的传输路径。
典型操作执行路径 SOP
下面的 SOP 不是 API 使用教程,而是 出现问题时按源码顺序定位责任组件 的执行清单。所有路径均对应固定 revision bfca1ce2。
SOP 1:Setup 与挂载容量
入口:mooncake_store_create(),随后调用 mooncake_store_setup(...)
- 在
store_c.cpp确认mooncake_store_create已生成持有RealClient的StoreHandle;setup参数随后进入RealClient::setup_real。 - 在
RealClient::setup_internal确认Client::Create成功,Master 地址、Transfer Engine metadata 地址与协议一致。 - 检查
ConnectToMaster是否取得 Store 配置;HA 部署还要确认 leader discovery 结果。 local_buffer_size > 0时,确认本地缓冲池分配和RegisterLocalMemory(..., remote_accessible=false)成功。global_segment_size > 0时,确认每块内存先注册为可远端访问,再经MountSegmentAndGetId出现在 Master 的 Segment 表中。
成功标志:Client 拥有有效 ID;需要的 Segment 已挂载;TransferSubmitter 已初始化。常见断点:Master 不可达、Transfer Engine endpoint 不可解析、内存注册失败、Segment 名称或容量冲突。
SOP 2:Put 一个对象
入口:mooncake_store_put(handle, key, value, length, ...)
store_c.cpp::mooncake_store_put
  → RealClient::put
  → RealClient::put_internal
      → ClientBufferAllocator::allocate
      → gather_maybe_device_to_host
      → split_into_slices
  → Client::Put
      → MasterClient::PutStart
      → MasterService::PutStart
      → AllocateAndInsertMetadata [Replica=PROCESSING]
      → Client::TransferWrite
      → TransferSubmitter::submit
      → DetermineFinalizeDecision
      → MasterClient::PutEnd 或 PutRevoke
排障时按三个检查点推进:
- PutStart 前失败:优先看 Key、长度、租户与参数校验。
- PutStart 后传输失败:检查返回 Replica 的 endpoint/address、内存注册、Batch 状态与具体 transport 错误。
- 数据写完但对象查不到:检查
DetermineFinalizeDecision是否选择PutEnd、writer ID 是否匹配、Replica 是否最终变为COMPLETE。
成功标志:Master 已移除 processing_keys 中的 Key,至少一个满足策略的 Replica 为 COMPLETE,Query 可返回该对象。不要只以某个 Transfer Batch 完成为 Put 成功。
SOP 3:Get 到已有 Buffer
入口:mooncake_store_get_into(handle, key, buffer, length, ...)
store_c.cpp::mooncake_store_get_into
  → RealClient::get_into
  → Client::Query
      → MasterClient::GetReplicaList
      → MasterService::GetReplicaList [只返回可读 COMPLETE 副本]
  → RealClient::SelectBestReplica
  → Client::Get
      → TransferRead / DFS Read / hot cache
      → checksum 校验
      → Lease deadline 校验
- Query Miss:先确认 Key 是否完全一致,再检查对象是否仍为
PROCESSING、Lease/淘汰是否移除全部副本。 - 有 Replica 但读失败:逐个核对副本类型、endpoint 可达性、refcount、Batch 完成状态和目标 Buffer 长度。
- 读完仍失败:检查 checksum 与本地计算是否一致,以及 Lease 是否在慢传输期间过期。
成功标志:目标 Slice 全部填充,checksum 与 Lease 检查通过。Master 只参与 Query,不应在网络抓包中承载 Value 大流量。
SOP 4:Remove 一个对象
入口:mooncake_store_remove(handle, key)
mooncake_store_remove
  → RealClient::remove
  → Client::Remove
  → MasterClient::Remove
  → MasterService::Remove
      → 检查 Lease、processing 与 replication task
      → 移除对象元数据
      → Replica 析构/回收释放物理空间
默认 Remove 会拒绝仍受 Lease 保护或尚未完成写入/复制的对象;force 也不是无条件跳过所有安全检查。成功标志是元数据查询不再返回对象,并且相应 Segment 或存储后端空间最终被回收。若 Remove 被拒绝,应先看 Lease 和 Replica 状态,而不是直接怀疑文件删除失败。
SOP 5:Batch Put/Get
Batch API 最终仍复用单对象的分配、传输和发布语义,只是把请求组织成批次以减少 RPC 与提交开销。排障时先拆出第一个失败 Key,按 SOP 2 或 SOP 3 追踪;不要把“Batch 返回部分成功”误读为单个对象允许部分发布。
回到两级缓存:PagedAttention 管理显存
放入依据
一段 KV Cache 只要要参与当前或下一次 Attention 计算,就必须位于 GPU 显存中。vLLM Scheduler 为请求分配 GPU Block,把物理 Block ID 写入 Block Table;Attention Kernel 再根据表中的 ID 读取对应 K/V。
GPU 中还可能暂时保留已经完成计算、具有 Prefix Cache Hash、但当前没有活动请求引用的 KV Block。这些块能够继续提供本地前缀命中,但也已经是可回收候选。
何时回收
GPU Block 是否可回收首先取决于引用计数:
ref_cnt > 0:仍被活动请求使用,不能复用。ref_cnt == 0:不再被请求引用,可以进入 Free Block Queue。
新请求需要更多 GPU Block 时,vLLM 从 Free Block Queue 取出候选块并复用物理空间。带 Prefix Cache Hash 的缓存块采用 FIFO 复用顺序形成近似 LRU 效果;没有缓存身份的块倾向于 LIFO 复用,以改善局部性。
这里的“GPU 淘汰”不等于一定执行 GPU → DRAM 写回:
- 如果 Mooncake 已经保存了外部副本,GPU 可以直接复用该物理块,未来仍能从 Store 恢复数据。
- 如果没有外部副本,旧数据会消失;后续相同前缀只能重新计算。
Mooncake 管理外部副本
Mooncake Store 不管理 vLLM 当前请求的 Block Table。它看到的是一个由 Block Hash 或 Key 标识的对象,以及这个对象对应的一个或多个副本:
Master 管理键、位置、副本状态和生命周期,正常 KV 载荷由 Client 与 Transfer Engine 搬运,不经过 Master 中转。
DRAM 放置与淘汰
KV Block 由 Connector 保存到 Mooncake 时,Store 从可用的 MEMORY Segment 中分配空间。这个初始放置主要依据可用 Segment、分配策略和副本配置,不是先预测冷热再决定是否进入 DRAM。
对象被读取或查询时,Mooncake 更新其 lease_timeout。后台内存淘汰通常在两种情况下触发:
- MEMORY 使用率超过高水位,默认是 90%。
- 新对象分配失败,设置内存淘汰标志。
候选对象还必须满足:
- Lease 已过期;
- 没有 Hard Pin;
- 存在完整、可读的 MEMORY 副本;
- 副本引用计数为 0;
- 第一轮优先跳过 Soft Pin,必要时第二轮再考虑。
Mooncake 比较对象的 lease_timeout,截止时间越早,表示越久没有访问,再用 nth_element 找到淘汰边界。因此这是对象级 Lease 近似 LRU,不是经典双向链表 LRU。
SSD 下沉与淘汰
只有启用 SSD Offload 后,KV Block 才会形成 LOCAL_DISK 副本。存在两种下沉时机:
- 立即下沉:
PutEnd成功后,将完整 MEMORY 副本加入 SSD 下沉队列。因此 SSD 中不一定只有冷数据。 - 淘汰时下沉:DRAM 准备淘汰对象时,先保留并固定一个 MEMORY 副本,写入 SSD;成功生成
LOCAL_DISK副本后,再释放 MEMORY。
在淘汰时下沉模式中,如果 Offload Queue 暂时不可用,默认行为是跳过本轮并保留数据;只有显式启用强制淘汰,才会在没有 SSD 副本时直接释放 MEMORY。
SSD 容量达到限制或高水位时,FileStorage 还会执行自己的淘汰:
- 默认
fifo:优先删除最早创建的 Bucket。 - 可选
lru:优先删除最久没有读取的 Bucket。 - 淘汰粒度是 Bucket:一个 Bucket 中的多个 KV 对象会一起删除,而不是精确淘汰单个 GPU 风格的 KV Page。
删除 SSD 数据前,FileStorage 先通知 Master 移除 LOCAL_DISK 副本元数据;通知失败则恢复本地索引。Master 确认后,FileStorage 等待正在进行的读取结束,再删除元数据文件和 Bucket 数据文件。
一次外部命中如何完成
当新请求到达时,Mooncake Store 与 PagedAttention 的协作顺序可以概括为:
- 计算内容身份。 按 Token Block 计算 Block Hash。
- 检查本地 GPU Cache。 如果已有可用 GPU Block,直接建立或复用 Block Table 映射。
- 查询 Mooncake。 本地未命中时,根据 Block Hash 查询 Master 中的副本元数据。
- 分配 GPU Block。 外部 DRAM/SSD 命中后,vLLM 仍要先申请新的 GPU 物理块。
- 传输 KV 数据。 Connector 与 Transfer Engine 将命中副本写入这些 GPU Block。
- 更新 Block Table。 将逻辑块映射到本次分配的 GPU Block ID。
- 执行 Attention。 Kernel 此时才能从显存读取 K/V。
新请求
  ↓
Token Blocks → Block Hash
  ↓
查询本地 GPU Prefix Cache
  ↓ 未命中
查询 Mooncake MEMORY / LOCAL_DISK
  ↓ 命中
分配新的 GPU Blocks
  ↓
装载 KV 数据并更新 Block Table
  ↓
执行 Attention
外部命中仍有成本
Mooncake 命中意味着可以避免对应前缀的重复 Prefill,但并不意味着数据已经位于 Attention 可直接访问的位置。DRAM/SSD 查询、数据传输、GPU Block 分配和同步仍然存在,因此外部命中不是免费的。
为什么两者如此相似
Mooncake Store 与 PagedAttention 都采用四个共同思想:
- 固定粒度切块。 不要求为整个请求分配一块连续空间。
- 逻辑与物理解耦。 逻辑顺序不要求物理位置连续。
- 间接寻址。 先查询映射,再找到真实数据。
- 按块复用与淘汰。 用有限容量保留更可能再次使用的数据。
但二者位于不同层级:
- PagedAttention 是执行期页式管理。 它解决 GPU 内 KV Block 的分配、映射、碎片与复用。
- Mooncake Store 是跨请求的外部缓存。 它解决 KV Block 如何按内容标识、保存副本、跨节点传输并在 DRAM/SSD 间管理生命周期。
从概念上可以把 Mooncake 看成 PagedAttention 外面的 L2/L3 缓存系统,但这不是说 Mooncake 扩展了同一张页表。它们拥有各自的元数据和淘汰策略,中间通过 Connector 显式搬运数据。
三套策略不要混用
| 层级 | 放置内容 | 放入依据 | 回收时机 | 策略 |
|---|---|---|---|---|
| GPU Block Table | 逻辑块到 GPU Block ID 的映射 | 当前调度批次与 GPU 分配结果 | 请求结束或槽位复用 | 重新构造,不下沉 SSD |
| GPU KV 数据页 | 活动请求与本地 Prefix Cache | Scheduler 分配、外部缓存装载 | ref_cnt=0 且需要新块 |
vLLM Free Queue,缓存块近似 LRU |
| Mooncake DRAM | 可跨请求、跨实例复用的 KV 副本 | Connector 保存,Store 分配 MEMORY Segment | 超过高水位或分配失败 | Lease 近似 LRU |
| Mooncake SSD | MEMORY 的下层副本 | 立即下沉或 DRAM 淘汰时下沉 | SSD 超容量或高水位 | 默认 FIFO,可选 Bucket LRU |
最容易出现的误解包括:
- 把页表当成 KV 数据。 页表很小,真正占据容量的是各层 K/V Tensor。
- 认为页表可以直接指向 SSD。 Attention 必须先看到 GPU Block,外部数据要显式装载。
- 认为存在统一的三级 LRU。 GPU、Mooncake DRAM 与 SSD 分别由不同组件管理。
- 认为 GPU 回收必然写回。 只有外部副本已经保存,数据才能在未来恢复;否则只能重算。
总结
PagedAttention 与 Mooncake Store 看起来相似,是因为它们都把连续的 KV Cache 切成块,并用间接映射代替固定物理位置。区别在于优化范围:PagedAttention 管理当前计算所需的 GPU 物理块,Mooncake Store 管理暂不在 GPU 中但值得跨请求复用的 DRAM/SSD 副本。
完整的数据生命周期不是一张页表在三级介质间移动,而是:GPU Block Table 持续描述当前执行地址;Connector 根据 Block Hash 查询外部副本;命中后将数据装入新 GPU Block,再重建执行映射。理解这一层次,才能正确区分显存复用、DRAM 淘汰、SSD 下沉和 SSD 自身淘汰。
参考资料
- Mooncake 开源仓库,本文涉及的 Mooncake 源码语义固定于
bfca1ce2af8419c50dc8d464820a95d97d43c930。 - Mooncake Store 设计。
- Mooncake 内存 near-LRU 定义。
- Mooncake 内存候选筛选。
- Mooncake SSD Bucket LRU。
- vLLM GPU Block Table。
- vLLM GPU BlockPool。
- vLLM MooncakeStoreConnector。
- Mooncake Store C API。
- RealClient 初始化与 Buffer 适配。
- Client 对象 API 与传输编排。
- MasterService 元数据与副本状态。
- TransferSubmitter 数据任务。
- Replica 类型与状态。