AIV Direct Drive Programming
导言
理解“AIV 直驱缩短了通信控制路径”之后,下一步不是立即抄一个 AllGather,而是先闭合一条最小链路:Host 建立资源并分配对称内存,启动一个 AIV Kernel;Kernel 把数据写到对端并发布 signal;接收端等待 signal,最后 Host 确认完成并按依赖顺序销毁资源。
本文基于 cann/shmem@382afa08efa801d7bca6c2645fd17e155111efcc 和 CANN 9.0.X / 9.0.0-beta.2 官方文档。代码是绑定该 revision 的教学归一化代码,不是承诺可在任意 CANN 版本直接编译的通用样例。
先选编程路径
“AIV 直驱”不是单一 API 名称。写代码前,先选清资源由谁管理。
| 路径 | Host 看见什么 | AIV 看见什么 | 适合起点 |
|---|---|---|---|
| HCCL 自定义 AIV 通信算子 | Engine Context、Notify 内存、Channel、HCCL Buffer、AIV binary | GM/LM、远端 buffer、软同步标记、Ascend C 搬运与同步 | 需要手工控制拓扑和 HCCL 通信资源 |
| cann/shmem 对称内存 | bootstrap 属性、Team、对称堆、ACL stream | PE、对称地址、Put/Get、Signal、Quiet、Barrier | 学习最小 Device 侧单边通信闭环 |
CANN 9.0.0-beta.2 的通信算子 API 列表把接口分成控制面与数据面;固定 SHMEM revision 则用 shmem.h 条件聚合 Host 和 Device 公共头(行 15-50)。二者可以建立相近的心智模型,却不能拼成一套对象模型:SHMEM 用户不需要伪造一个 ChannelHandle。
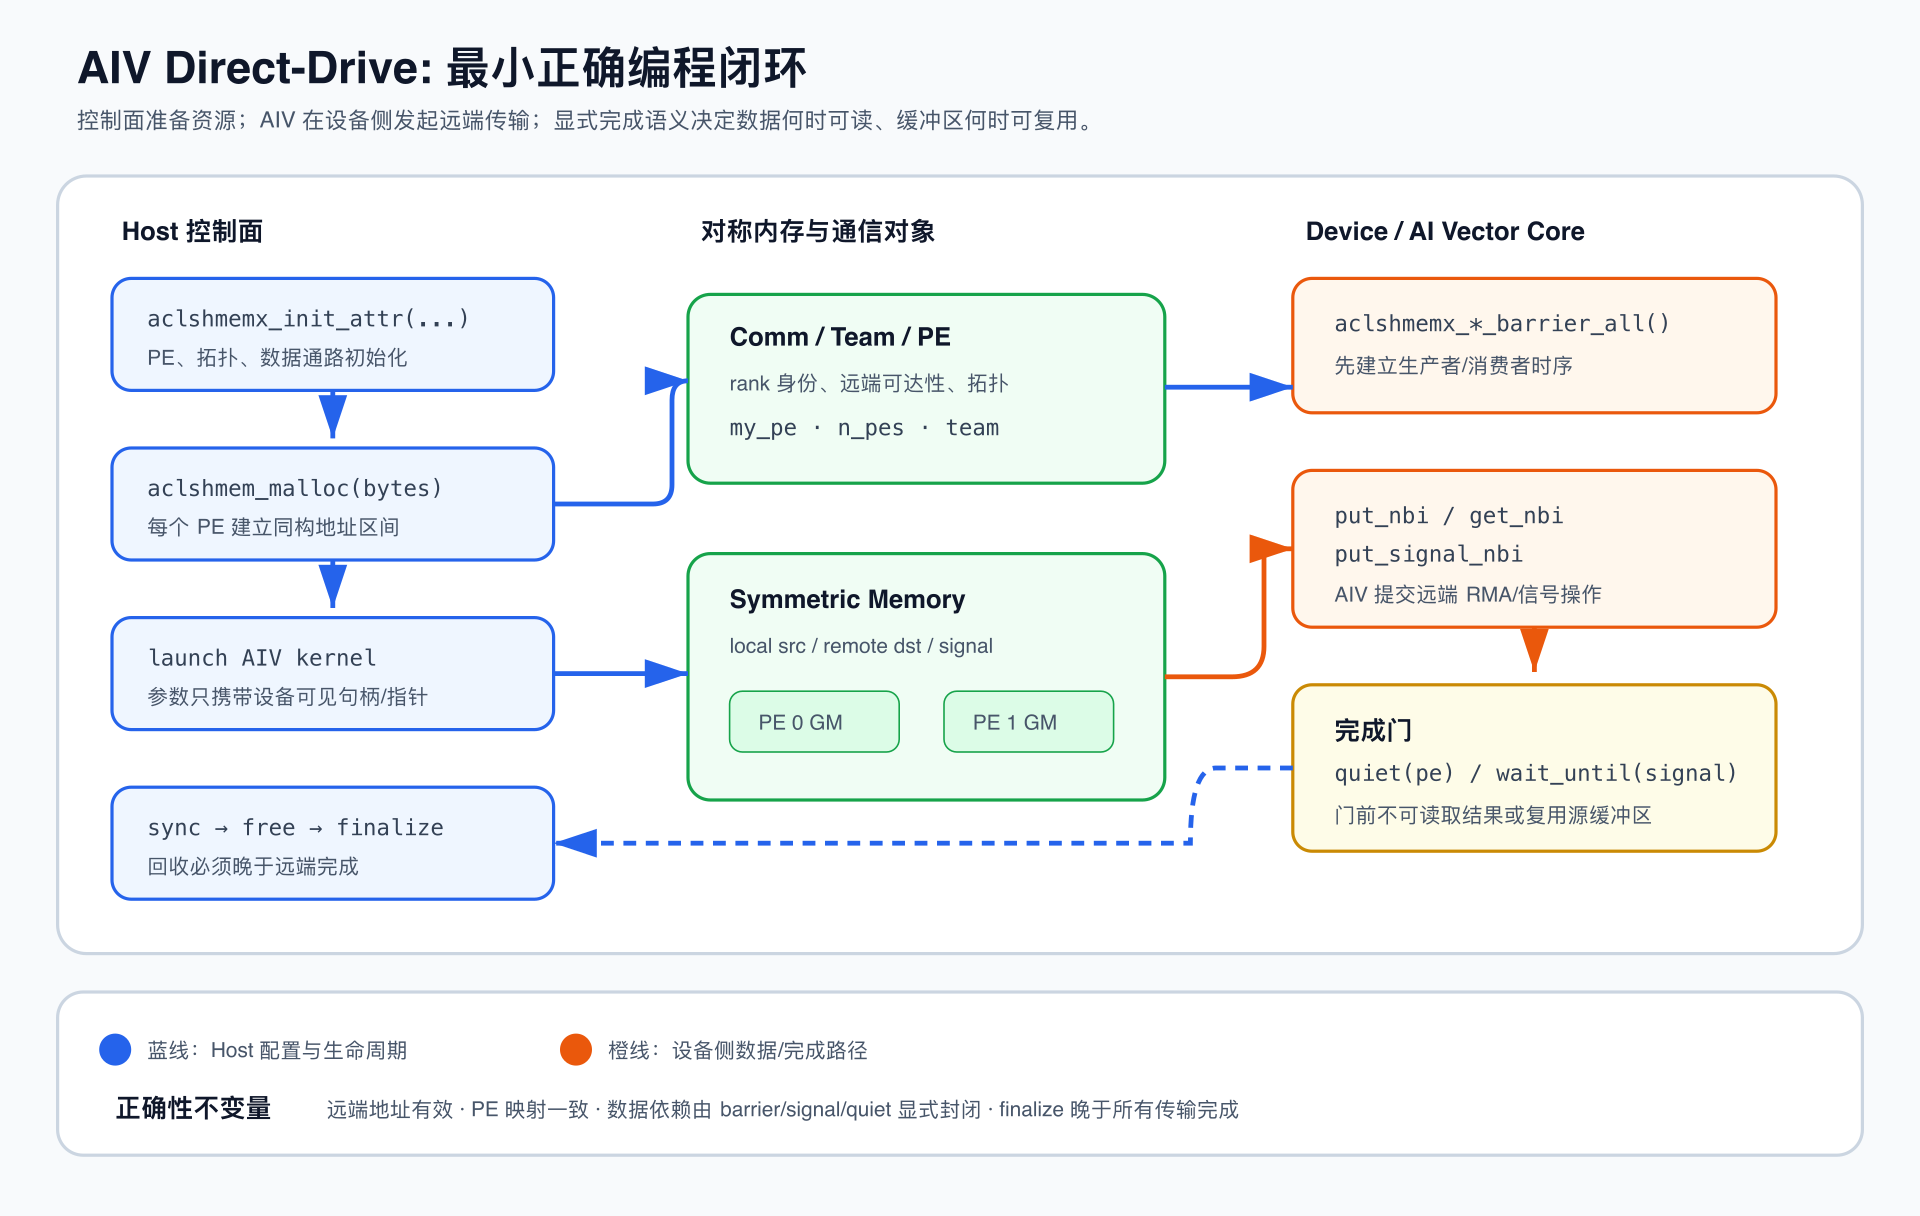
这张图只表达依赖关系。SHMEM 初始化的实现还会建立 bootstrap、映射对称堆并同步 device state;这些细节由库封装,业务代码不应调用 shmemi_* 内部符号。固定源码:docs/principles/init_finalize.md:1-23, 333-361
先读懂六类对象
Channel 与 Notify
在 HCCL 手工资源路径中:
- Channel 是跨 rank 的连接和远端资源可达关系,不是 payload。
- Notify 是同步状态的承载资源。AIV 软同步会把标记放在通信可见内存中,通过 GM 与 LM 之间的数据搬运完成 Record/Wait。
- HCCL Buffer 承载通信数据;Channel 让本端获得对端 buffer 或已注册 Notify 内存的描述。
官方创建资源页面按 Engine Context -> Notify 内存 -> HcclCommMemReg -> HcclChannelAcquire -> 查询本端/远端内存 展示流程;任务编排页面进一步说明 Record、Wait 和 GM-to-GM 搬运都会借助 Ascend C DataCopy 在 Local Memory 中转。
官方片段不等于完整工程
页面中的 CpGM2GM、Record1vN、WaitNv1 是示例封装;Context 大小、tag 管理、错误回滚和完整销毁也被省略。它们不能当作安装 CANN 后即可链接的基础 API。
对称内存与 PE
SHMEM 路径不让每次 Put 都携带远端虚拟地址描述,而是要求各 PE 建立布局一致的对称堆:
- 所有 PE 用相同参数参加 init,只有
my_pe不同。 - 所有 PE 以相同顺序、相同大小调用对称分配和释放。
- Kernel 把“本地对称地址 + 目标
pe”交给 SHMEM,库据此换算远端对应地址。
这个不变量见固定源码 docs/principles/init_finalize.md:13-23, 70-74,公开分配接口见 include/host/mem/shmem_host_heap.h:21-60。
把术语放回一条通信链路
前面的表格说明了两条编程路径,但第一次读这段代码时,名词仍然容易混在一起。一个简单的分法是:Engine Context 和 Notify 主要属于 HCCL 手工资源路径;bootstrap 属性、Team、对称堆、PE、Signal、Quiet 和 Barrier 主要属于 SHMEM 路径;ACL stream 则是 Host 提交和观察设备任务的运行时队列。
第一层:先把它们想成一次搬货
把两个 PE 想成两个仓库,把 Host 想成负责调度的管理员,把 AIV Kernel 想成真正搬货的人。
- Engine Context 是通信资源登记册。 它记录通信引擎、Channel、Notify 和远端内存等资源信息。它不是 payload,也不是 AIV 核本身。
- Notify 是 HCCL 路径上的状态牌。 发送端完成某个阶段后更新它,接收端通过 Record/Wait 判断什么时候可以继续。真正的货物仍然放在 HCCL Buffer 中。
- PE 是仓库的编号。 在最小例子里,PE 0 发送,PE 1 接收;PE 不是 AIV 核编号。
- Signal 是 SHMEM 路径上的远程门铃。 它只表达“某件事已经发生”,不负责搬运 payload。
data_ready表示数据可以消费,ack表示接收端已经越过了相应的完成边界。 - Quiet 是把自己发出的货物寄完。 它等待本 PE 在 Device 侧发起的 SHMEM 操作完成,但不等待所有 PE 集合,也不替 Host 确认 Kernel 已经返回。
- Barrier 是全员集合点名。 参与者都到达后才能继续,它和 Quiet 关注的对象不同。
- bootstrap 属性是开机时的集合配置。 它告诉 SHMEM“我是谁、总共有多少 PE、怎样找到参与者、对称堆准备多大”。
- Team 是参与者分组名单。 World Team 可以包含所有 PE,也可以把 PE 划分成更小的 Team;同步只对相应 Team 生效。
- 对称堆是每个仓库都按同一张图纸摆放的储物区。 各 PE 以相同顺序、相同大小分配,于是同一个对称地址可以配合目标 PE 找到对端的对应位置。但它不是一块真正统一的物理内存。
- ACL stream 是管理员提交任务的传送带。 Kernel 和其他异步设备任务排入其中,同一条 stream 保持提交顺序;
aclrtSynchronizeStream则让 Host 等待这条传送带上的任务完成。
在这个类比中,真正的最小闭环是:
Host:bootstrap 属性 → Team / 对称堆 → ACL stream → 启动 Kernel

PE 0:把 payload 写给 PE 1 → 发布 data_ready → 等待 ack
PE 1:等待 data_ready → 消费 payload → 发布 ack

Host:stream synchronize → 释放对称内存 → finalize
类比只帮助区分“货物、状态牌、参与者和任务队列”。它不能说明真实的物理内存一定共享,也不能把 Notify 和 Signal 当成同一个 API。
第二层:对应到真实机制
在 HCCL 手工资源路径中,HcclEngineCtxCreate/Get 操作的是通信引擎上下文。对 AIV 引擎,Context 资源流程会关联用于软同步的 Notify 内存;随后通过 HcclCommMemReg 注册它,再由 HcclChannelAcquire 建立跨 rank 的 Channel,并查询本端和远端的通信内存。Channel 描述的是连接和资源可达关系,Notify 描述的是同步状态,HCCL Buffer 承载的是数据。
在 SHMEM 路径中,Host 先用 aclshmemx_init_attr_t 调用 aclshmemx_init_attr。除 my_pe 外,各 PE 的初始化参数需要保持一致;初始化过程由库建立 bootstrap、对称堆、Team、Signal 和同步资源。之后,各 PE 必须以相同顺序、相同大小进行对称分配和释放。
Device 侧的 RMA 操作使用“对称地址 + 目标 PE”定位远端内存。put 或 get 负责移动数据,Signal 和等待 API 负责发布、观察同步状态。对于非阻塞操作,put_nbi 返回只表示请求已经发起,不能直接推出远端数据已经可以消费;通常需要先 quiet,再单独发布 Signal。同步的 put-with-signal 则把“先复制数据、后更新远端 Signal”的顺序封装起来。
Barrier 是参与 PE 的集体同步,不是任意两个操作之间的万能补丁。固定 revision 中,Device barrier 还有 Kernel 形态和编译限制;而 aclshmem_sync 只解决相应的普通内存同步,并不等价于完成 SHMEM 的远端更新。即使 Device 侧已经完成,Host 仍然需要通过 aclrtSynchronizeStream 或其他 Device 同步接口观察 Kernel 的完成。
三个完成边界
不要把以下三个判断写成等式:put_nbi 返回不等于远端可消费;Signal 可见不等于任意独立 payload 都已完成;quiet、Device barrier 和 aclrtSynchronizeStream 也不等价。最小例子用 put-with-signal 和 ACK,是为了把“数据先于状态发布、接收端先于发送端退出”的关系明确写出来。
最小对象账本
下面的闭环只处理两个 PE 和 64 B payload。先把物理对象与指针视图分开,代码会更不容易写错。
| 对象 | 类型 | 所在域 | 容量 | 生命周期与约束 |
|---|---|---|---|---|
attr |
Host 配置 | 每个进程 | 一个结构体 | init 前创建;除 my_pe 外保持一致 |
stream |
ACL 句柄 | Host | 一条 stream | launch 前创建;free/finalize 前同步 |
payload |
物理对称分配 | Device GM | 64 B | 每个 PE 同序同大小分配;PE 0 是源,PE 1 的对应偏移是目标 |
signals |
物理对称分配 | Device GM | 2 * 8 B |
每个 signal slot 使用 ACLSHMEM_SIGNAL_SIZE;固定源码定义为 8 B |
data_ready |
signals 的代数视图 |
AIV | slot 0 | PE 0 更新 PE 1;PE 1 在本地等待 |
ack |
signals 的代数视图 |
AIV | slot 1 | PE 1 更新 PE 0;PE 0 在本地等待 |
pe |
代数索引 | AIV | 标量 | 由 aclshmem_my_pe() 查询;本例只接受 0 或 1 |
Signal slot 的固定 revision 定义见 include/host_device/shmem_common_types.h:142-144,PE 查询接口见 include/device/team/shmem_device_team.h:22-36。
最小 Host + Kernel 闭环
代码身份
以下代码不使用省略号,但仍是教学归一化代码。公共 SHMEM API 来自固定 revision;LaunchAivOneWay、CheckOrAbortAll 和 CMake target 是教学工程自己的符号。要编译,必须把 Kernel 与 wrapper 接入该 revision 的 bisheng/CMake 构建,并匹配实际 SoC、CANN、ops 包和驱动固件。
AIV Kernel
选择同步 typed put-with-signal,是因为公共头明确规定它先复制数据,再更新远端 signal,并且只支持单核调用。这个限制见 include/device/gm2gm/shmem_device_so.h:55-128。
// aiv_one_way_kernel.cpp:教学归一化代码,绑定 shmem@382afa08...
#include "kernel_operator.h"
#include "shmem.h"

extern "C" [[bisheng::core_ratio(0, 1)]] __global__ __aicore__
void AivOneWay(GM_ADDR payload_addr, GM_ADDR signals_addr,
               uint32_t payload_bytes)
{
    if (GetBlockIdx() != 0 || aclshmem_n_pes() != 2) {
        return;
    }

    auto *payload = reinterpret_cast<__gm__ uint8_t *>(payload_addr);
    auto *signal_bytes = reinterpret_cast<__gm__ uint8_t *>(signals_addr);
    auto *data_ready = reinterpret_cast<__gm__ int32_t *>(signal_bytes);
    auto *ack = reinterpret_cast<__gm__ int32_t *>(
        signal_bytes + ACLSHMEM_SIGNAL_SIZE);

    const int pe = aclshmem_my_pe();
    if (pe == 0) {
        // dst 和 data_ready 都是本地对称地址;最后一个参数选择远端 PE 1。
        aclshmem_uint8_put_signal(
            payload, payload, payload_bytes,
            data_ready, 1, ACLSHMEM_SIGNAL_SET, 1);

        // 发送端只有收到 ACK 才允许 Kernel 结束。
        aclshmem_signal_wait_until(ack, ACLSHMEM_CMP_EQ, 1);
    } else {
        // put-with-signal 保证 signal 发布在 payload 复制之后。
        aclshmem_signal_wait_until(data_ready, ACLSHMEM_CMP_EQ, 1);

        // 通知 PE 0:PE 1 已经越过 data-ready 边界。
        aclshmemx_signal_op(ack, 1, ACLSHMEM_SIGNAL_SET, 0);
        aclshmem_quiet();
    }
}

void LaunchAivOneWay(uint32_t block_dim, void *stream,
                     uint8_t *payload, uint8_t *signals,
                     uint32_t payload_bytes)
{
    AivOneWay<<<block_dim, nullptr, stream>>>(
        payload, signals, payload_bytes);
}
固定仓库采用相同的 AIV Kernel 声明与 <<<block_dim, nullptr, stream>>> wrapper 形态。examples/allgather/allgather_kernel.cpp:288-330 中的 allgather_demo 和 examples/udma_demo/udma_demo_kernel.cpp:66-105 中的 launch 函数都是示例 wrapper,不是 SHMEM 公共 API。
Host 生命周期
下面固定 n_pes = 2,每个进程由 launcher 传入 pe_id、device_id 和 rank 0 的 tcp://host:port。正常路径展示完整销毁顺序;异常路径采用集群 fail-fast,要求 launcher 同时终止两个 PE,以免只有一个 PE 退出、另一个卡在 collective。
// main.cpp:教学归一化代码,绑定 shmem@382afa08...
#include <acl/acl.h>
#include <algorithm>
#include <array>
#include <cstdio>
#include <cstdlib>
#include <cstring>
#include "shmem.h"

extern void LaunchAivOneWay(uint32_t block_dim, void *stream,
                            uint8_t *payload, uint8_t *signals,
                            uint32_t payload_bytes);

constexpr int kPeCount = 2;
constexpr uint32_t kPayloadBytes = 64;
constexpr uint64_t kSymmetricHeapBytes = 1UL << 20;

[[noreturn]] void CheckOrAbortAll(const char *stage, int code)
{
    std::fprintf(stderr, "%s failed, code=%d; launcher must stop both PEs\n",
                 stage, code);
    std::abort();
}

void Check(const char *stage, int code, int success)
{
    if (code != success) {
        CheckOrAbortAll(stage, code);
    }
}

int main(int argc, char **argv)
{
    if (argc != 4) {
        std::fprintf(stderr,
            "usage: %s <pe_id:0|1> <device_id> <tcp://rank0-host:port>\n",
            argv[0]);
        return 2;
    }

    const int pe_id = std::atoi(argv[1]);
    const int device_id = std::atoi(argv[2]);
    if (pe_id < 0 || pe_id >= kPeCount) {
        return 2;
    }

    Check("aclInit", aclInit(nullptr), ACL_SUCCESS);
    Check("aclrtSetDevice", aclrtSetDevice(device_id), ACL_SUCCESS);

    aclrtStream stream = nullptr;
    Check("aclrtCreateStream", aclrtCreateStream(&stream), ACL_SUCCESS);

    aclshmemx_init_attr_t attr{};
    attr.my_pe = pe_id;
    attr.n_pes = kPeCount;
    attr.local_mem_size = kSymmetricHeapBytes;
    const int written = std::snprintf(
        attr.ip_port, sizeof(attr.ip_port), "%s", argv[3]);
    if (written <= 0 || static_cast<size_t>(written) >= sizeof(attr.ip_port)) {
        CheckOrAbortAll("ip_port", ACLSHMEM_INVALID_VALUE);
    }

    Check("aclshmemx_init_attr",
          aclshmemx_init_attr(ACLSHMEMX_INIT_WITH_DEFAULT, &attr),
          ACLSHMEM_SUCCESS);

    auto *payload = static_cast<uint8_t *>(
        aclshmem_calloc(1, kPayloadBytes));
    auto *signals = static_cast<uint8_t *>(
        aclshmem_calloc(2, ACLSHMEM_SIGNAL_SIZE));
    if (payload == nullptr || signals == nullptr) {
        CheckOrAbortAll("aclshmem_calloc", ACLSHMEM_MALLOC_FAILED);
    }

    std::array<uint8_t, kPayloadBytes> host_data{};
    if (pe_id == 0) {
        host_data.fill(0x5A);
        Check("payload H2D",
              aclrtMemcpy(payload, kPayloadBytes,
                          host_data.data(), host_data.size(),
                          ACL_MEMCPY_HOST_TO_DEVICE),
              ACL_SUCCESS);
    }

    LaunchAivOneWay(1, stream, payload, signals, kPayloadBytes);
    Check("aclrtSynchronizeStream",
          aclrtSynchronizeStream(stream), ACL_SUCCESS);

    if (pe_id == 1) {
        Check("payload D2H",
              aclrtMemcpy(host_data.data(), host_data.size(),
                          payload, kPayloadBytes,
                          ACL_MEMCPY_DEVICE_TO_HOST),
              ACL_SUCCESS);
        if (!std::all_of(host_data.begin(), host_data.end(),
                         [](uint8_t x) { return x == 0x5A; })) {
            CheckOrAbortAll("payload validation", ACLSHMEM_INNER_ERROR);
        }
    }

    // 所有 PE 必须以相同顺序释放;这里按分配的逆序释放。
    aclshmem_free(signals);
    aclshmem_free(payload);
    Check("aclshmem_finalize", aclshmem_finalize(), ACLSHMEM_SUCCESS);
    Check("aclrtDestroyStream", aclrtDestroyStream(stream), ACL_SUCCESS);
    Check("aclrtResetDevice", aclrtResetDevice(device_id), ACL_SUCCESS);
    Check("aclFinalize", aclFinalize(), ACL_SUCCESS);
    return 0;
}
这里直接构造 aclshmemx_init_attr_t,依赖固定 revision 的默认 option_attr 为 MTE;结构定义和公开 init/finalize 入口见 include/host/shmem_host_def.h:145-195 与 include/host/init/shmem_host_init.h:94-208。仓库的 test_set_attr 位于 examples/utils/utils.h:141-160,只是样例 helper,不能当作公共 API。
sequenceDiagram
    participant H0 as Host PE 0
    participant V0 as AIV PE 0
    participant V1 as AIV PE 1
    participant H1 as Host PE 1
    H0->>V0: launch one AIV core
    H1->>V1: launch one AIV core
    V0->>V1: put payload, then set data_ready
    V1->>V1: wait data_ready == 1
    V1->>V0: set ack = 1, quiet
    V0->>V0: wait ack == 1
    V0-->>H0: kernel return + stream sync
    V1-->>H1: kernel return + stream sync
    H0->>H0: free, finalize, destroy ACL resources
    H1->>H1: free, finalize, destroy ACL resources
基础 API 地图
Host 侧
| API | 作用 | 完成或集体性 | 证据 |
|---|---|---|---|
aclshmemx_init_attr |
按 bootstrap 属性建立 SHMEM 资源 | 所有 PE 对称参加;参数布局一致 | include/host/init/shmem_host_init.h:137-147 |
aclshmemx_get_uniqueid、aclshmemx_set_attr_uniqueid_args |
使用 UID 模式准备属性 | UID 的跨 PE 广播由应用负责 | 同文件行 94-118 |
aclshmem_malloc/calloc/align/free |
管理对称堆 | 各 PE 同序同大小 | include/host/mem/shmem_host_heap.h:21-60 |
aclshmem_barrier(_all) |
Host 参与者会合并完成此前 CPU 侧 remote updates | 不替 NPU 侧完成 | include/host/data_plane/shmem_host_cc.h:28-49 |
aclshmemx_barrier_all_on_stream |
把 barrier 排入指定 stream | 用于 stream 顺序,但仍需按版本确认场景 | 同文件行 51-68 |
aclshmem_finalize |
释放当前 instance | 所有 PE 对称调用;之后不得再调用 SHMEM API | docs/principles/init_finalize.md:70-74 |
AIV 侧
| API | 作用 | 最容易误解的边界 | 证据 |
|---|---|---|---|
aclshmem_my_pe/n_pes |
查询本 PE 与参与者数 | PE 是进程/通信参与者,不是 AIV 核 ID | include/device/team/shmem_device_team.h:22-36 |
aclshmem_*_put/get |
同步 Put/Get | 远端操作数必须是对称地址;RDMA 对两端范围要求更严 | include/device/gm2gm/shmem_device_rma.h:154-173, 315-335 |
aclshmem_*_put_nbi/get_nbi |
非阻塞发起 RMA | 返回不代表可消费或可复用 | 同文件行 477-525, 670-715 |
aclshmem_putmem_signal、typed variants |
Put 后更新远端 signal | 只支持单核或单 writer | include/device/gm2gm/shmem_device_so.h:55-128 |
aclshmemx_signal_op |
远端 signal SET/ADD | 分离的数据移动必须先建立 data-before-signal | include/device/gm2gm/shmem_device_p2p_sync.h:23-36 |
aclshmem_signal_wait_until |
阻塞等待本地 signal 条件 | 看见 signal 不自动证明任意独立 RMA 已完成 | 同文件行 38-51 |
aclshmem_quiet |
完成本 PE 在 NPU 侧发起的 SHMEM 操作 | Host 仍需 stream/device synchronize | include/device/gm2gm/shmem_device_mo.h:23-35 |
aclshmem_barrier |
PE 会合,并完成此前 remote updates | 全核 API 对 MIX Kernel 有限制;CPU/NPU 完成域分离 | include/device/gm2gm/shmem_device_cc.h:15-77 |
aclshmem_sync、aclshmemx_sync_vec |
同步普通 memory stores | 不完成 SHMEM remote updates | 同文件行 79-124 |
固定 revision 中 aclshmem_fence 因当前硬件实现与 quiet 相同,同时提供排序和完成;这只是 include/device/gm2gm/shmem_device_mo.h:37-48 的 revision 行为,不能外推为所有版本或其他 SHMEM 实现的规范。
完成语义
把“函数返回”拆成四级,能避开大多数直驱错误:
- Issued:
*_nbi已经发起,源和目标仍可能在使用。 - Device complete:
aclshmem_quiet让调用 PE 的 NPU 侧 SHMEM 操作完成。 - Remote consumable:生产者通过 put-with-signal,或先 quiet 再 signal;消费者 wait 到匹配 signal 后才能越过数据依赖。
- Host observed:Host 通过
aclrtSynchronizeStream或 device synchronize 确认 Kernel 完成。
stateDiagram-v2
    [*] --> Issued: put_nbi / get_nbi
    Issued --> DeviceComplete: quiet
    DeviceComplete --> Published: signal
    Published --> Consumable: remote wait satisfied
    Consumable --> HostObserved: stream synchronize
    HostObserved --> [*]: free / finalize
三个错误等式
_nbi return == remote data ready:错误,仍需 quiet 或等价完成机制。signal visible == 任意 payload 完成:错误,必须先建立 data-before-signal。sync == barrier == quiet:错误;固定 revision 的 vec sync 明确不完成 SHMEM remote updates。
固定仓库 allgather 小数据路径在 examples/allgather/allgather_kernel.cpp:263-285 中展示了 put_nbi -> quiet -> SyncAll -> signal/wait -> get_nbi。但公共同步头又提示不要在同一 Kernel 混用 ACLSHMEM inter-PE synchronization 与 SyncAll。本文优先遵循公共头限制,最小例只用一个 AIV 核和 SHMEM P2P 同步,不机械复制该多核示例。
Tiling 与下发
SHMEM 直启
固定仓库示例把元素数、buffer 指针和 FFTS 地址作为普通 Kernel 参数,wrapper 直接使用 <<<block_dim, nullptr, stream>>>。这种写法的“tiling”只是应用自己计算参数和 block 数,不等于框架注册的 TilingFunction。
框架算子 Tiling
框架自定义算子通常由 Host TilingFunction 计算 TilingData,Kernel 再用 GET_TILING_DATA 取出。CANN 9.0.X 的 GET_TILING_DATA 官方页面明确写明:该宏当前不支持 Kernel Launch 工程。
迁移原则:
- 先让直启最小闭环用普通参数跑通。
- 接入框架时新增算子注册、Host TilingFunction 与 TilingData 序列化。
- 不要在未经目标 CANN 版本验证的直启工程中直接加入
GET_TILING_DATA。
HCCL AIV binary 下发
CANN 9.0.0-beta.2 的算子下发页面给出另一条版本化路径:查询 Vector Core 资源,加载独立 Kernel .o,取得函数句柄,设置 ACL_RT_ENGINE_TYPE_AIV,再调用 aclrtLaunchKernelWithHostArgs。该片段还要求 Device binary 带 AIV meta section。
这条路径适合 HCCL 自定义通信算子,但页面没有给出完整参数 ABI、binary 构建 target 与失败回滚,不能把片段改名后当作完整 launch helper。
手工 Channel 路线
如果业务必须接管 HCCL 通信资源,Host 侧最小资源关系是:
flowchart TD
    COMM[已有 HCCL 通信域] --> CTX[HcclEngineCtxCreate: AIV Notify 区]
    CTX --> ZERO[aclrtMemset 清零]
    ZERO --> REG[HcclCommMemReg]
    REG --> DESC[HcclChannelDescInit + remoteRank]
    DESC --> CH[HcclChannelAcquire]
    CH --> LOCAL[HcclGetHcclBuffer]
    CH --> REMOTE[HcclChannelGetHcclBuffer]
    CH --> TAG[HcclChannelGetRemoteMems]
    LOCAL --> BIN[加载并下发 AIV binary]
    REMOTE --> BIN
    TAG --> BIN
这里要严格区分:
HcclEngineCtxCreate、HcclCommMemReg、HcclChannelAcquire和查询函数列在 beta.2 公开 API 页面中,属于版本化公开接口。CpGM2GM、Record1vN、WaitNv1是文档示例封装。HcommEndpointCreate/HcommChannelCreate是另一组较新的基础资源 API;不能在没有产品与 CANN 版本验证时替换 legacy HCCL Channel 路线。- 官方页面提供
HcclEngineCtxDestroy,但没有在同一流程中给出与HcclChannelAcquire配对的完整 Channel 回收代码。销毁必须服从目标版本通信域的所有权规则,本文不猜测缺失接口。
错误与销毁边界
必须拒绝的输入
n_pes与实际启动进程数不一致,或my_pe越界。- 各 PE 的
local_mem_size、bootstrap 模式、对称分配顺序或大小不一致。 - Put/Get 的远端地址不在对称堆中;启用 RDMA 时,完整源/目标范围不满足对称内存约束。
- 多个 AIV 核并发调用只支持单核的 put-with-signal。
free或finalize时仍有 Kernel 或 stream 在访问对称对象。- 一个 PE 局部返回,其他 PE 继续进入 collective。
正常销毁偏序
停止新 launch
    -> aclrtSynchronizeStream
    -> 所有 PE 同序 aclshmem_free
    -> 所有 PE aclshmem_finalize
    -> aclrtDestroyStream
    -> aclrtResetDevice
    -> aclFinalize
固定仓库的直接通信示例采用 free -> finalize -> destroy stream -> reset device -> aclFinalize,见 examples/udma_demo/main.cpp:123-135;更强的不变量是 finalize 前 Kernel 已完成,finalize 在 device reset 和 ACL finalize 前,所有 PE 对称参与。
失败路径不能只写 goto cleanup
多 PE 程序中,本地 cleanup 可能本身就是 collective。生产实现要用 launcher、MPI 或独立 control plane 汇总错误,再让全部 PE 一致退出;不能让一个 PE 执行 aclshmem_free/finalize,另一个 PE 已经返回。
编译环境
固定 revision 的 docs/quickstart.md:28-75, 195-229, 323-347给出以下边界:
- 硬件:Atlas 800I/800T A2/A3、Ascend 950;Host 为 aarch64 或 x86。
- 工具链:gcc/g++ 不低于 7.3 且版本一致,CMake 不低于 3.19,GLIBC 不低于 2.28,Python 不低于 3.9;Device Kernel 使用 CANN toolkit 随附的
bisheng。 - 环境:先加载 CANN
set_env.sh;源码构建后加载 SHMEMinstall/set_env.sh。 - 版本:HDK 25.0.RC1.1 配 CANN 8.5 以上可用 MTE/RDMA;CANN 9.0.0-beta.2 以上增加表内 SDMA 能力;HDK 26.0.RC1 配 CANN 9.1 以上时,A3 可用 SDMA,Ascend 950 可用 UDMA。实际通路仍受 SoC 与 ops 包限制。
- 构建:A2/A3 示例使用
bash scripts/build.sh -examples;Ascend 950 使用bash scripts/build.sh -soc_type Ascend950 -examples。
本文没有宣称已经编译
当前草稿在 macOS 本地完成,只做了固定源码与 Markdown 静态核验;本机没有 Ascend NPU、CANN toolkit、匹配 ops 包和 bisheng。要把教学例变成可执行样例,仍需接入 pinned SHMEM 的 example/CMake target,在目标 SoC 上完成双 PE 编译、运行、结果校验和失败注入。
仓库 README 也明确指出 examples 只供学习参考,生产使用前需完成功能与性能测试,并建议锁定 CANN 版本。README.md:260-264
总结
最基础的 AIV 直驱程序可以压缩为五个不变量:
- Host 先建资源:ACL device/stream、bootstrap、Team 与对称堆都在 Kernel 前完成。
- 地址必须可解释:SHMEM 用“对称地址 + PE”,HCCL 手工路线用 Channel 交换的远端资源。
- 数据与状态分开:Put/Get 搬 payload,Signal/Notify 发布依赖;二者必须有明确顺序。
- 完成分层:NBI 发起、Device quiet、远端可消费、Host stream observed 是不同边界。
- 销毁服从偏序:先完成 Kernel,再同序 free 和 collective finalize,最后释放 ACL 资源。
最小闭环跑通后,才适合增加多核切分、框架 Tiling、RDMA/SDMA/UDMA 引擎、Team 集合通信与性能流水。否则,复杂示例中的每一个 SyncAll、signal offset 和 block 数都可能掩盖真正的生命周期错误。
参考资料
- cann/shmem 固定源码,commit 382afa08efa801d7bca6c2645fd17e155111efcc
- SHMEM 对外头文件与库,
docs/public-headers-and-libraries.md:21-73 - SHMEM 初始化与终止,
docs/principles/init_finalize.md:1-108, 333-361 - CANN 9.0.0-beta.2:通信算子开发 API 列表
- CANN 9.0.0-beta.2:AIV 创建资源
- CANN 9.0.0-beta.2:AIV 任务编排
- CANN 9.0.0-beta.2:AIV 算子下发
- CANN 9.0.X:
GET_TILING_DATA